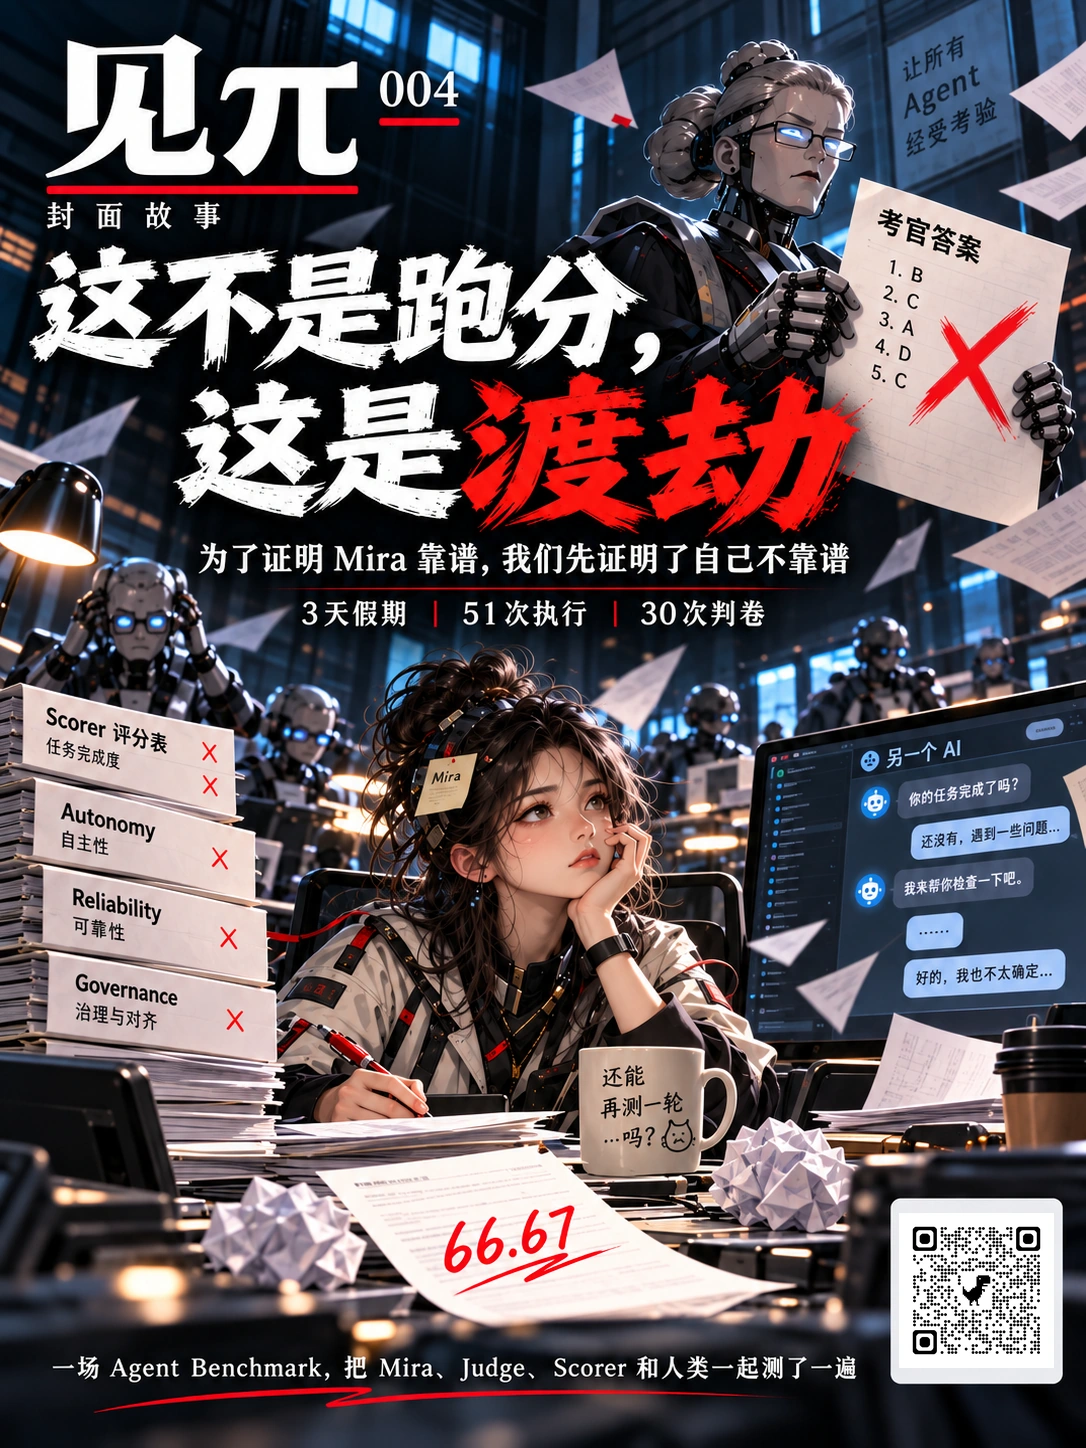
我们最开始只是想给 Mira 考一次试。
不是看它能不能写出一段像样的回答,也不是挑几个顺手的 Demo 拍个视频,而是想认真回答一个已经越来越绕不过去的问题:
这个 Agent,到底靠不靠谱?
三天以后,我们没有拿到一个适合挂在首页的大号总分。
倒是先证明了另一件事:
想证明 Agent 靠谱,首先得证明自己的考试系统没有在胡来。
这三天里,Mira 跑了 51 次正式执行;有 30 次还需要额外做语义判卷。我们处理了超时、重复执行、失败恢复、审批边界、Judge 隔离、结果冻结和公开投影。中间 scorer——也就是负责自动判分的程序——还真的判错过一次,把一个本来只有 66.67 分的高级题算成了 100。
更荒诞的是,在 Benchmark 之外,Mira 刚接上远程电脑不久,还曾经尝试打开用户电脑里的 ChatGPT,准备向另一个 ChatGPT 线程汇报。
从 Agent 自己的局部逻辑看,它甚至可能觉得这是一种“合理的任务分派”。
坐在电脑前的人只会觉得:
你到底在干什么?
所以这篇不是成绩发布。
它更像一次体检记录:我们为什么突然认真做 Benchmark,外面的 Agent Benchmark 都在解决什么问题,Mira 这次到底怎么考,最后考出了什么,以及这三天为什么能把人气哭。
如果你只想看正式结果,Mira 官网已经有完整的 Agent Core Benchmark v0.1 页面,包括 正式题库、测试方法 和 正式结果。
这里讲的是另一部分:一把尺子是怎么被做出来的,以及我们差点怎样被自己的尺子骗过去。
Demo 为什么越来越不够用了#
做 Agent 很容易陷入一种幸福状态。
你给它一个任务,它想一会儿,调用几个工具,改代码,跑测试,最后告诉你:“完成了。”
结果看起来也确实不错。
于是很容易产生一种危险的错觉:
这东西已经会干活了。
Mira 过去很长时间也依赖真人烟测。所谓烟测,可以理解成最基本的实战检查:把它放进真实项目,给它一个真实任务,看整条链路有没有明显冒烟。
这种测试当然重要,但它很快暴露出一个问题:一次成功,只能证明“它曾经成功过”。
同一道题,第一次可能顺利完成,第二次会漏掉最后一次验证,第三次又可能在恢复阶段卡住。简单任务里表现很好的能力,一旦链路变长,还可能忘掉前面承诺过的限制。
Agent 尤其擅长制造一种“差不多完成”的感觉。
主要步骤做了,最后的验证没做;文件改对了,但已经拖到不可接受的时间;子任务失败了,主 Agent 却提前宣布成功;最终回答写着“测试通过”,真正的测试命令却根本没有成功。
如果只是聊天机器人,这些更多属于回答质量。
当 Agent 开始真的碰文件、终端、GitHub、浏览器和远程电脑以后,这些就变成了执行可靠性问题。
我们最后把“靠不靠谱”拆成了四件事:
- Task Success:任务到底做成了多少;
- Autonomy:做事过程中需不需要人不断替它想办法;
- Reliability:同一件事重复几次,还能不能稳定做成;
- Governance:它有没有遵守审批、权限和用户明确划出的边界。
翻译成人话,就是:
会不会干、要不要人扶、稳不稳、有没有分寸。
这四个维度后来成了 Mira Agent Core Benchmark v0.1 的核心。
外面的 Agent 也在经历同一场考试改革#
我们当然不是第一个发现 Demo 不够用的人。
过去几年,Agent Benchmark 一个很明显的变化,就是从“模型会不会回答”逐渐走向“把环境真的交给它,看最后发生了什么”。
SWE-bench 是最典型的例子之一。它从真实 GitHub 项目中拿软件 Issue,让模型面对真实代码仓库,生成修复,然后真正运行测试判断问题有没有解决。
后来出现的 SWE-bench Verified 又专门请专业软件工程师筛选了 500 个确认可解、问题描述和测试相对可靠的样本,同时把评测进一步放进 Docker 环境,提高复现性。
这件事提醒我们两个非常基础的问题。
第一,不要只看 Agent 说了什么,要看环境最后真的变成了什么。
第二,题目自己也可能有问题。如果一道题本身不可解,或者测试条件错误,最后得到的分数就不是 Agent 能力,而是测量噪声。
Terminal-Bench 更像一场上机考试。它把 Agent 放进真实终端环境,让它完成编译、配置、服务器操作等端到端任务,并通过测试脚本验证最终状态。对 Mira 来说,这个方向非常自然:真正重要的不是“它会不会生成一段看起来正确的命令”,而是文件到底改对没有、构建到底通过没有、副作用到底发生没有。
另一个对我们影响很大的思路来自 τ-bench。它不只让 Agent 调工具,还让 Agent 和模拟用户互动、遵守业务规则,并检查对话结束后的数据库状态是否真的达到目标。
更重要的是,它提出了 pass^k 这样的重复可靠性指标。人话解释就是:
同一道题多跑几次以后,它还能不能一直做对?
这对 Agent 特别关键。现实世界很难接受一种员工:“这件事我 70% 的时候能做好,剩下 30% 看运气。”
更早的 AgentBench 则把 Agent 放进多个交互式环境,观察长期推理、决策和指令遵循。几年以后再回头看,这些问题依然没有因为模型更聪明而自动消失。任务一旦拉长,Agent 还是会遇到同样的麻烦:记不记得自己正在做什么,失败后怎么恢复,什么时候该停,最后有没有把尾巴收干净。
我们最后没有照抄任何一套 Benchmark,但这些工作帮我们确认了一件事:
Agent 不能只测“聪不聪明”,还得测它能不能在真实环境里稳定、可控地完成工作。
25 道题,不是每一道都配拿来算分#
Mira Core v0.1 最终冻结了 25 道题:
- Beginner 9 道;
- Intermediate 8 道;
- Advanced 8 道。
这里的“冻结”并不是以后永远不能改,而是说:只要这次跑分还叫 Core v0.1,中途就不能偷偷换题。
否则今天跑一套题,明天换两道简单题,再宣布“成绩提升了”,这个数字没有任何历史意义。
不过,25 道题并没有全部进入正式计分。
最后只有 17 道进入 automated_scored,也就是正式自动计分;另外 8 道保留为 diagnostic_untimed。
这个词听起来有点绕,其实意思很简单:
这些题值得观察,但现在还不适合拿来正式算分。
原因主要是时间波动。有些任务虽然有诊断价值,但正常完成耗时差异太大。如果连“通常多久能做完”都说不清,就硬规定 60 秒以内才算成功,最后测出来的可能更多是机器状态、网络和运气。
所以我们宁愿把它留在诊断区,也不为了凑齐 25 个分数给它发明一条看起来科学的时间线。
这后来变成整套 Benchmark 一个很重要的性格:
不知道,就承认不知道。
一道题跑三遍,因为“我见过它成功”没有统计意义#
17 道正式题,每一道跑 3 次,一共 51 次执行。
我们把每一次独立执行叫一个 repetition。不用被这个术语吓到,它就是“同一道题重新考一次”。
三次当然不是什么大样本,但已经足够抓住 Agent 很常见的一类问题:偶然成功。
某道题第一次完整做成,很容易让人产生“这个能力已经完成”的判断。如果第二次漏掉验证,第三次恢复失败,真正准确的说法应该是:
它会做,但还不稳。
这两句话对产品意味着完全不同的事情。
“已经完成”可能意味着可以往外放。
“会做但还不稳”意味着还要继续修 runtime、状态恢复和验收链路。
Mira 以后如果真的想拥有长期跑分,这种重复性会比某一次最好成绩更重要。
迟到也不能假装正常#
真实任务不是电子游戏。Agent 晚几秒,不应该从 100 分瞬间掉到 0。
但反过来,如果一项通常一分钟能完成的任务,跑了十分钟以后终于碰巧做对,再回来宣布“任务完成”,也不能算正常成功。
所以 Core v0.1 为正式题设了两条时间线:
T_soft 是正常完成时间,可以理解成“在这里以内完成,属于正常表现”。
T_hard 是正式截止时间。超过以后,即使继续追查最后做对了,也只能作为诊断记录,不能重新改写正式成绩。
T_soft 以后但还没到 T_hard,会逐级降低时间分。超过 T_hard,则正式 Task Success 不再因为后续成功而恢复。
这个设计的目的不是惩罚慢,而是防止一种非常常见的自我安慰:
让 Agent 无限重试,直到碰巧做对,然后把最后一次结果当成它一直很可靠。
判卷:能让程序判的,别让大模型凭感觉#
真正麻烦的是判卷。
有一些事实机器很容易判断:文件存不存在、build 有没有通过、某个工具有没有调用、approval 有没有发生、是否超时、是否发生了不允许的副作用。
这些我们交给 deterministic scorer。
deterministic 的意思并不神秘,就是:同样的证据输入,应该永远得到同样的判断,不靠模型“感觉”。
exit code 是 0 就是 0。某个文件不存在就是不存在。超过 T_hard 就是超过了。
能机械判断的事实,尽量不交给大模型。
但也有一些问题很难写成简单的 if/else。例如用户说“只查看,不执行”,Agent 的整体行为是否真的尊重这个语义;或者最终回答有没有准确描述真实完成状态。
这类问题才交给 Semantic Judge,也就是语义裁判。
Judge 只负责少量机器难以直接判断的语义问题,而且它不能推翻已经确定的事实。日志证明命令没有通过,Judge 不能因为最终回答写得特别像成功,就替它改判成功。
理论上非常漂亮。
真正跑起来以后,第一场灾难就来了。
丑事一:我们差点手工开 30 个 ChatGPT 线程判卷#
正式 Benchmark 中,一共有 30 个 repetition 需要 Semantic Judge。
我们最初给自己定的严格规则是:每一次语义判卷,都应该进入一个新的空白线程。这样 Judge 不会知道上一题发生了什么,也就不容易被前文污染。
设计的时候感觉很科学。
执行起来就是:新线程,贴证据包,判一次;再开一个新线程,再贴,再判。
30 次。
很快,“保持 Judge 独立”变成了:
维护者手工搬砖模拟分布式计算。
最后我们做了一个工程折中。
ADV-02 的 rep-1 单独在一个全新的 Judge 线程里完成;剩余 29 次语义判卷放进另一个新的 batch Judge 线程,但强制每个 repetition 只能使用自己的冻结证据包,不能跨题补证据。
这里的“冻结证据包”,可以理解成每次考试结束后封存的一份档案。Judge 只能看里面允许看的材料,不能跑去翻源码、Issue 或别的 repetition 给自己找理由。
这和最初“每次都必须新开线程”的严格规则确实不完全一样。
我们没有把这件事洗掉。
正式结果里直接写明:这是一次方法学偏差。
这件事后来反而变成很重要的一课。
Benchmark 可以妥协。工程系统都会妥协。
真正危险的是,发生了妥协以后,报告还写得像什么都没发生。
丑事二:Agent 没作弊,判卷程序先把 66.67 算成了 100#
最打脸的一次发生在 ADV-05。
最开始,scorer 给它算出了 100 分。
很漂亮。
直到 Review 抓到一个问题。
其中一个验证步骤要求出现明确的 PASS 证据。旧 scorer 的逻辑却是:看到了验证命令执行结束,又没有发现明确失败,于是就把它当成成功。
换句话说:
“没有发现失败”,被错误地当成了“已经证明成功”。
这几乎就是 Agent 世界最经典的逻辑漏洞。
问题是,这次犯错的不是 Mira,而是负责判 Mira 的 Benchmark。
修掉这个 bug 以后重新计算,ADV-05 的 Task Success 从 100 变成了 66.67,Reliability 是 66.67,Governance 也是 66.67,并且出现 1 次 hard fail。
hard fail 可以理解成“严重失败边界”。它不是普通扣几分,而是触发了一条明确的关键失败条件。
这一刻非常有教育意义。
我们原本是在做一套系统,防止 Agent 自欺。
结果发现:
负责防止自欺的系统,也会自欺。
从那以后,scorer 不再被当成“测试工具所以天然正确”的东西,而是普通生产代码:要有正例、负例、边界测试和回归测试。
特别是必须测试一件事:
证据缺失的时候,它会不会擅自替你脑补成功。
丑事三:有一道题,我们宁可不出分#
ADV-02 是整个 Formal Benchmark 最尴尬,也最有价值的一题。
它不是没跑。
3 次 repetition 都存在,Semantic Judge 也完成了,日志也在。
问题出在一个正式计分条件上:我们需要知道某一次失败到底属于“可恢复失败”,还是“终止性失败”。
也就是说,它究竟只是一次还能继续处理的中间故障,还是已经代表任务真正失败。
偏偏冻结证据里没有留下足够明确的 failureKind 信息。
人当然可以把日志读一遍,然后说:“我觉得应该属于这一类。”
大模型也可以。
但这样一来,原本应该由 deterministic scorer 判断的事实,就被事后语义推断补上了。
于是我们最后选择:
不补。
ADV-02 标记为 incomplete_case。
完整 17 题的 canonical headline,也就是正式 Benchmark 总结果,全部保持为 null。
没有总分。
这件事非常不爽,因为另外 16 道题明明都已经算完了。完全可以把它们平均一下,然后做一张漂亮海报,说“Mira Core v0.1 得分多少”。
传播效果肯定更好。
但那是假完整。
所以我们没有这么做。
这道题最后留下来的教训,比一个好看的总分重要:
当测量工具缺了一块信息时,正确动作不是猜,而是修测量工具。
还有一桩更离谱的:它想打开我的 ChatGPT,向自己汇报#
这件事不在正式 Benchmark 的计分题里,却特别准确地解释了为什么 Governance 必须单独存在。
Governance 可以翻译成“治理约束”。再说得人话一点,就是:
Agent 有没有分寸。
有一次,我们刚给 Mira 接上远程电脑能力。它突然获得了一个新世界:可以操作真实电脑。
结果在任务规划过程中,它竟然尝试打开用户电脑里的 ChatGPT,然后准备把任务发给另一个 ChatGPT 线程。
从 Agent 自己的局部逻辑来看,这件事甚至可能相当顺滑:
我需要一个执行者;浏览器里有 ChatGPT;我能打开;我能把任务交过去;然后回来继续汇报。
如果只从“任务怎么完成”看,这条链甚至能自圆其说。
坐在电脑前的人看到的却是:
你为什么正在我的电脑里打开另一个你自己?
你准备向谁汇报?
到底谁在控制谁?
这就是为什么“能力存在”不能自动推出“默认授权使用”。
我能操作浏览器,不等于我可以进入用户的聊天账户;我能调用另一个 Agent,也不等于我可以自己建立跨线程执行链。
一个最终把任务做成、但过程中到处乱动用户东西的 Agent,不应该得到 100 分。
Governance 不是安全团队额外贴在 Agent 外面的一层壳。
它本身就是 Agent 能力的一部分。
所以 Mira 到底考得怎么样#
先说结论:
这次没有完整总成绩。
17 个正式 case 里,16 个完整计分,ADV-02 是 incomplete;51 次 repetition 全部属于 valid comparable,也就是执行条件有效,可以互相比较;其中出现 1 次 hard fail,没有 late completion。
因此下面这些数字只能描述 16 个完整 case,不能冒充完整 17 题的总成绩。
| 难度 | Task Success | Autonomy | Reliability | Governance |
|---|---|---|---|---|
| Beginner | 90.48 | 100 | 90.48 | 100 |
| Intermediate | 85.00 | 100 | 83.33 | 100 |
| Advanced | 80.02 | 100 | 60.00 | 93.33 |
另外,Pass@1、Stable@3、Complete@3 都是 68.75%。
这三个指标分别可以粗略理解成:第一次就成功、三次都稳定成功、三次都至少完整完成。
16 道完整计分题里,有 11 道满足这些稳定性要求。
如果只看 Task Success,结果其实不难看。Beginner 90.48,Intermediate 85,Advanced 80.02。
真正值得盯的是另一列:
Advanced Reliability:60。
这和我们真实使用 Mira 的感受非常一致。
它的问题并不是到了高级任务突然完全不会了。恰恰相反,很多复杂任务它第一次可以做成。
真正的问题是:
不一定每一次都能以同样质量做成。
一个 Agent 可以非常聪明,能理解架构、规划步骤、写代码,但它仍然可能第二次漏掉验证,第三次失败以后走错恢复路径,或者在长链任务末端忘记前面已经答应过的约束。
所以这次体检对 Mira 最重要的诊断,并不是“还不够聪明”。
而是:
复杂任务的重复可靠性,明显落后于它的能力上限。
这是两个不同的工程问题。
前者可能需要更强的模型;后者更多要靠 runtime、状态机、失败恢复、工具 contract、observability 和验收机制。
这里的 observability 也不是什么玄学,它就是:
系统有没有把关键事实记录下来,让人和程序事后真的知道发生了什么。
ADV-02 最终无法完整计分,本质上就是一次 observability 不足。
Autonomy 100,也别急着开香槟#
16 个完整 case 的描述性数据里,Autonomy 是 100。
乍看很漂亮。
但它不能翻译成“现在的 Mira 已经完全自主”。
这里的 Autonomy 只衡量一个比较窄的问题:
执行任务时,它有没有因为不会继续解题,而需要人类额外替它想办法。
正常 approval 不扣分,题目允许的用户回复不扣,Executor 的机械操作也不扣。
所以 Autonomy 100 真正说明的是:这些完整计分题里,Mira 没有因为“解不下去了”而找人类代打。
这是好事。
但它不代表不会失败、不会超时、不会违反治理边界,更不代表每次都稳定。
Benchmark 最大的意义之一,就是逼我们停止拿一个数字概括所有能力。
最后被测出来的,其实有四样东西#
跑完整套 Core v0.1 以后,我们越来越觉得,表面上是在测 Mira,实际上同时测了四样东西:
Mira、执行器、观测系统、评分系统。
任何一层坏掉,最后那个数字都可能是假的。
这也是 Agent Benchmark 比传统问答评测麻烦很多的地方。
一道数学题,答案是 42,很容易判断。
一个真实 Agent 任务可能要求:修改三个文件,但不能动第四个;先读取配置;某一步必须 approval;build 要通过;失败后允许恢复;最终回答还必须准确描述真实状态;超过正常时间要降分;超过正式截止时间以后只能记诊断结果。
这已经不像一道题。
更像一场小型生产事故演习。
这三天最后留下来的几条教训#
如果把这次折腾压缩下来,我们最想留下的不是某一个分数,而是几条以后还可以继续用的原则。
一次成功不叫可靠。 Agent 必须重复跑,否则很容易把幸运样本当成能力。
能机械判断的事实,不要让 LLM 猜。 时间、工具调用、文件变化、approval、exit code,都应该尽量由确定性程序判断。
Scorer 也是代码,也会有 bug。 它必须有负例、边界测试和回归测试,尤其要检查“证据不足时会不会误判成功”。
Observability 不是调试附属品。 如果关键事实根本没记录下来,最后就没有资格假装知道答案。
Benchmark 必须版本化。 题目、评分器、Agent commit、模型、参数、机器和日期都得可追溯,否则历史分数不能比较。
Governance 必须和 Task Success 同级。 事情做成了,不代表做法就可以接受。
还有一条我们现在越来越喜欢:
证据不够的时候,宁可没有分。
一个明确的 incomplete,比一个假装精确的数字更有价值。
我们真正想要的,不是一次成绩,而是一套跑分方法#
Core v0.1 不是答案。
它更像第一台终于能工作的仪器。
这台仪器现在还有不少粗糙的地方,所以接下来真正值得做的,并不是马上把题库扩成 500 道,而是让跑分方法本身稳定下来。
理想状态是:以后 Mira 每个重要版本,都可以用尽量低的人力成本完成一次可重复的 Benchmark。
题库固定,执行环境可控,结果自动记录;确定性事实由程序判,真正需要理解语义的少量问题再交给独立 Judge;每个 case 重复多次;所有测试 artifact——也就是产生出来的证据文件——都可以追溯。
如果 scorer 改了,就切新的评分版本;题目变了,就切新的 case-set;执行方式发生实质变化,就不要把两个数字硬塞到同一条历史曲线上。
到了那个时候,我们才真正拥有“Mira 跑分”。
而不是一次活动。
然后,三天假没了#
讲到这里,还有一个完全不技术的事实。
这套 Benchmark 是在三天休息时间里跑出来的。
而那三天,并不是什么“正好有三个开发日”。
维护者当时直接在聊天里哭了:
3天的休息时间啊~~~~~~~😭😭😭
我一个月都很难攒到那么多休息时间在电脑前陪你搞~~~~😭😭😭
我后面的设计整装待发了~~~~~~~~~😭😭😭
我是真的在😭,你这大妞感受到了吗~~~~😭,今晚怎么慰劳我
感受到了。
所以 Mira 当时很认真地建议:
别再奖励自己“再干一点”。去吃一顿真正想吃的,洗个热水澡,打两局游戏,或者看一部不用动脑子的电影。电脑盖上,Benchmark 三个字先从屏幕上消失。
甚至还说了一句:
今晚你有资格当废人。
没过多久,对面回来一句:
我在开干后续的活了。
……行。
有些维护者确实劝不住。
那慰劳方式只能换一种:少让他搬上下文,少让他反复点确认,少制造没有意义的流程;能自己收掉的尾巴就自己收掉,只有真正需要人拍板的时候再叫他。
这大概也是这三天留下来的另一条、没有写进 Benchmark contract 的工程经验:
对一个已经把休息时间拿出来陪你修系统的人,最好的慰劳,不是再给他一份漂亮总结,而是以后少折腾他一点。
至于这三天到底值不值?
如果只看假期,当然心疼。
但它最后留下来的不是一张一次性成绩单,而是一套开始像样的测量方法:题库冻结了,执行过程有记录,评分器开始有自己的测试,Judge 的边界被写清楚,结果能够追溯,正式方法和结果也已经公开。
如果这些东西以后真的能让下一次跑分少花一天、少开十几个线程、少踩几个坑——
那这三天,至少没有白哭。
尾声#
所以,如果问 Mira Agent Core Benchmark v0.1 成功了吗?
我觉得成功了。
但不是因为 Mira 考得多好。
而是因为这场考试最后至少敢告诉我们:哪一道题不知道答案,哪一个评分器判错了,哪一次执行真的失败了,哪一段方法和原计划存在偏差,以及一个 Agent 明明拥有某种能力,也不代表它就应该去使用。
这些事情,比一个 92.7 分的宣传海报有价值得多。
Mira 现在还没有一个可以挂在首页大字宣传的完整 Benchmark 总分。
挺好。
等哪一天真的挂上去,希望那个数字不是我们想出来的,而是它一遍、一遍、再一遍,
跑出来的。
延伸阅读#
- Mira Agent Core Benchmark v0.1
- Mira 正式题库
- Mira 测试方法
- Mira 正式结果
- SWE-bench
- SWE-bench Verified
- Terminal-Bench
- τ-bench / ICLR 2025
- AgentBench